安全在庫は、需要のばらつきとリードタイムの間に生じるリスクを吸収するための在庫です。本記事では、Python の statistics モジュールを用いて、サービスレベル別に必要な安全在庫と発注点を計算する方法を解説します。
安全在庫とは何を守るための在庫か
安全在庫は、需要のばらつきやリードタイム中の需要増に対応するために、通常必要量に上乗せして持つ在庫です。需要が一定であれば、発注した分が到着するまでの間に必要な量だけ備えれば済みます。しかし、実際の需要は日によって変動します。この変動が大きいほど、予期せぬ欠品リスクが高まります。
安全在庫の役割は、この「ばらつき」による欠品を防ぐことです。具体的には、補充サイクル中に在庫が切れない確率、すなわちサイクルサービスレベルを確保するために必要な量として設定されます。サービスレベルを高く設定すればするほど、欠品しにくくなりますが、その分だけ在庫量が増加します。
つまり、安全在庫は単なる「余裕」ではなく、設定したサービスレベルに基づいて計算される、欠品リスクを管理するための在庫です。需要の予測精度やリードタイムの安定性、そして許容できる欠品頻度によって、最適な量は変わります。
計算式と安全係数 z
安全在庫の計算式は「安全在庫 = z × 需要の標準偏差 × √リードタイム」です。この式は、需要のばらつきとリードタイムの長さに応じて、どの程度のバッファ在庫が必要かを定量化します。
各項の意味を整理します。まず「z」は安全係数と呼ばれ、目標とするサービスレベルによって決まる数値です。サービスレベルとは、補充サイクル中に欠品が起きない確率(サイクルサービスレベル)を指します。次に「需要の標準偏差」は、過去の実績から推定される需要のばらつきの大きさです。最後に「√リードタイム」は、発注から到着までの日数の平方根です。リードタイムが長いほど、需要が変動する期間が長くなるため、在庫の必要量も増えます。
z の値は、正規分布の性質から導かれます。例えば、サービスレベル90%なら z は1.28、95%なら1.64、99%なら2.33となります。サービスレベルを高く設定すればするほど、z の値は大きくなり、結果として安全在庫も多くなります(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
ここで注意が必要です。本記事で使用する数値は、乱数で生成した架空のサンプルデータによるものです。実際の業務では、自社の出荷実績や需要予測に基づいて標準偏差を推定し、適切なサービスレベルを設定する必要があります。
Pythonで安全在庫と発注点を計算する
ここでは、Python の statistics モジュールを用いて安全在庫と発注点を計算します。まず、計算ロジックを関数として定義します。
安全係数 z・安全在庫・発注点を計算する関数
import math
from statistics import NormalDist


def z_value(service_level: float) -> float:
    """サービスレベル(補充サイクル中に欠品しない確率)に対応する安全係数 z。"""
    return NormalDist().inv_cdf(service_level)


def safety_stock(daily_sd: float, lead_time_days: float, service_level: float) -> float:
    """安全在庫 = z × 需要の標準偏差 × √リードタイム(需要のばらつきだけを考える基本形)。"""
    return z_value(service_level) * daily_sd * math.sqrt(lead_time_days)


def reorder_point(daily_mean: float, daily_sd: float, lead_time_days: float, service_level: float) -> float:
    """発注点 = リードタイム中の平均需要 + 安全在庫。"""
    return daily_mean * lead_time_days + safety_stock(daily_sd, lead_time_days, service_level)
この関数は、日平均需要、需要の標準偏差、リードタイム、および目標サービスレベルを受け取ります。正規分布の性質に基づき、安全係数 z を特定し、安全在庫と発注点を算出します。計算例の数値は、乱数で生成した架空のサンプルデータによるものです(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
次に、具体的な数値を代入して実行します。
サービスレベル 90・95・99% で安全在庫と発注点を計算する
daily_mean, daily_sd, lead_time = 100, 20, 7   # 1日の平均需要100個、標準偏差20個、リードタイム7日

for sl in (0.90, 0.95, 0.99):
    ss = safety_stock(daily_sd, lead_time, sl)
    rop = reorder_point(daily_mean, daily_sd, lead_time, sl)
    print(f"サービスレベル{sl:.0%}: z={z_value(sl):.2f}  安全在庫={ss:.0f}個  発注点={rop:.0f}個")
この実行例では、日平均需要 100個、標準偏差 20個、リードタイム 7日の条件を設定しています。これにより、リードタイム中の需要は 700個 となります(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
結果として、サービスレベル 90% では安全在庫 68個、発注点 768個が得られます。95% では安全在庫 87個、発注点 787個、99% では安全在庫 123個、発注点 823個となります(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
サービスレベルを上げると在庫はどう増えるか
サービスレベルを上げると、必要な安全在庫はどのように変化するかを比較します。前提として、需要は正規分布に従い、平均100個/日・標準偏差20個・リードタイム7日とします。これらの数値は乱数で生成した架空のサンプルデータによるものです。
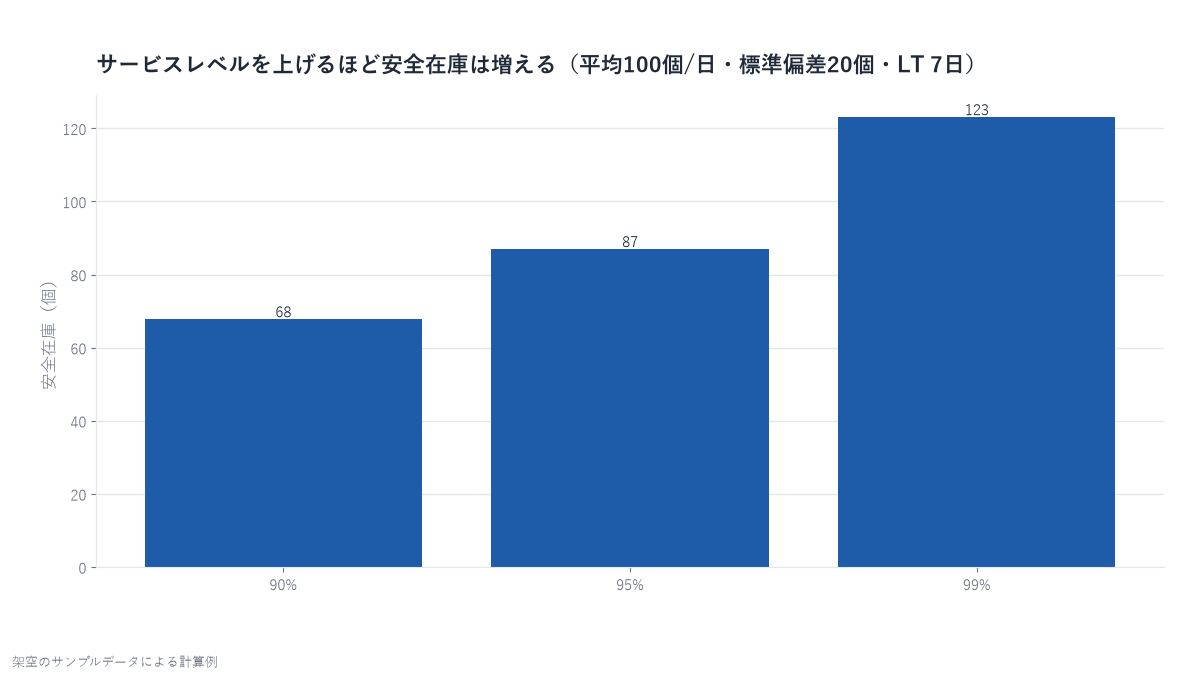
サービスレベル90%の場合、安全在庫は68個です。これを95%に上げると87個となり、さらに99%にすると123個に増加します(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
特に95%から99%への引き上げでは、安全在庫が41%増加します。この差は、高い確率で欠品を防ぐために、分布の裾(極端な需要増)まで在庫を確保する必要があるためです(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
実務では、この41%の在庫増加がもたらす保管コストや廃棄リスクを、欠品による機会損失と天秤にかけます。すべての品目で99%を目指すのではなく、欠品影響が大きい品目には高いサービスレベルを設定し、それ以外は95%程度で運用するといった、品目ごとの使い分けを検討する余地があります。
需要のばらつきが大きい品目ほど効く
需要のばらつきが大きい品目ほど、安全在庫の計算は重要になります。サービスレベル95%・リードタイム7日の条件で、需要の標準偏差を変えた場合の安全在庫の推移を示します。
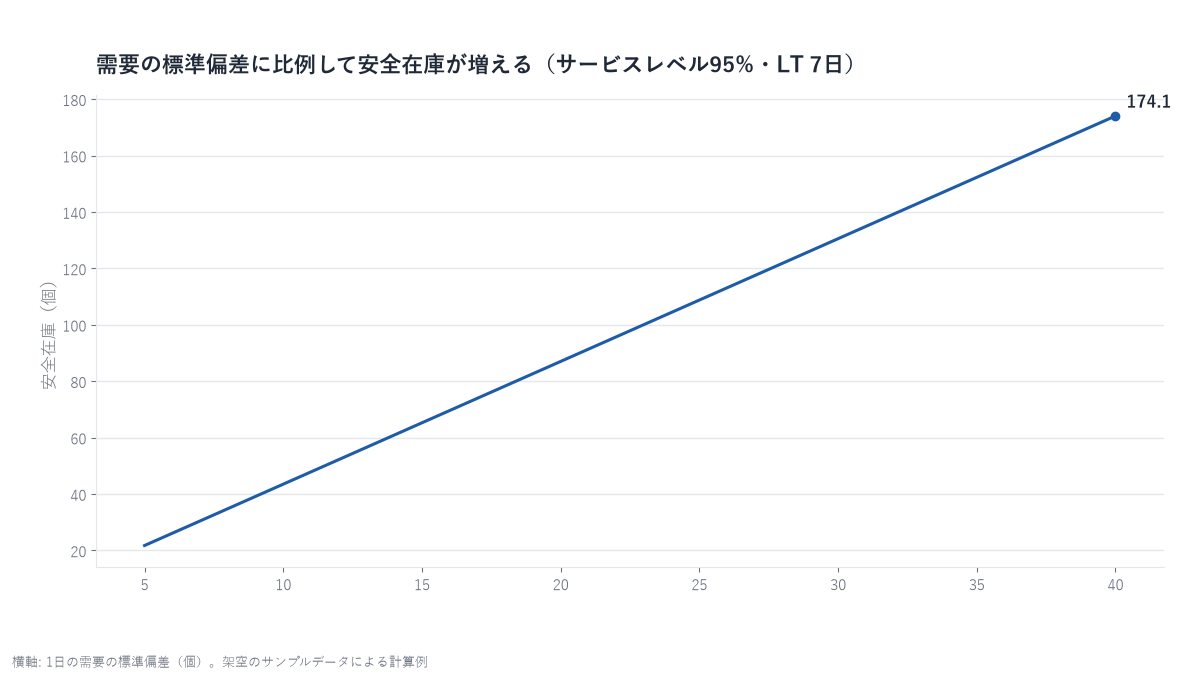
標準偏差が10個のときは44個、20個のときは87個、40個のときは174個と、標準偏差が倍になると安全在庫もほぼ倍に増えます(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
この線形な関係から、需要のばらつきを小さくする取り組みは、計算上は安全在庫の削減につながります。具体的には、需要予測の精度向上や、発注量の平準化が挙げられます。ばらつきを減らすことで、同じサービスレベルを維持しつつ、必要な安全在庫を抑制できる可能性があります。
実務で使うときの注意点
本記事の計算は、需要が正規分布に従い、リードタイムが一定であるという前提に基づいています。また、需要の標準偏差は、日別の出荷数などの過去の実績データから推定します。
これらの前提が崩れる場合、例えば需要が正規分布から大きく外れる、あるいはリードタイムにばらつきがある場合、単純な計算式では実際のリスクを過小評価する可能性があります。その際は、前提条件を再確認し、より詳細なシミュレーションや、ばらつきを反映したモデルの検討が必要になります。数値はあくまで特定の条件下での結果であり、実務では自社のデータ特性に合わせて解釈することが重要です。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
まとめ
安全在庫は、需要のばらつきとリードタイムの間に生じるリスクを吸収するための在庫です。計算では、正規分布の安全係数 z を用いて、目標のサイクルサービスレベルに応じた必要量を決めます。
Python の statistics モジュールを使えば、平均と標準偏差から発注点を簡単に算出できます。サービスレベルを上げると在庫は増え、需要のばらつきが大きい品目ほどその影響は大きくなります。
計算方法と注意
- 前提: 需要は正規分布に従い、リードタイムは一定とする(リードタイムのばらつきは考慮しない)
- 需要の標準偏差は過去の実績(日別の出荷数など)から推定する
- サービスレベルは「補充サイクル中に欠品が起きない確率(サイクルサービスレベル)」の意味
- 計算例の数値は架空のサンプルデータによるもの
出典
- 本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード)
本記事のコードと数値は、乱数で生成した架空のサンプルデータによる再現可能な計算例です。