需要予測の精度を測る指標として、MAE・MAPE・WAPE・バイアスの違いを解説します。PythonとNumPyを用いた計算例を通じて、各指標が示す情報と使い分け方を実務的に確認できます。
予測精度を測らないと何が起きるか
需要予測の精度を数値で測らないと、安全在庫の設定や予測手法の改善が困難になります。感覚的な評価では、どの品目で予測がずれているのか特定しきれません。結果として、過剰在庫や欠品が慢性化するリスクがあります。
精度指標には、それぞれ「見えるもの」が異なります。平均的な誤差の大きさ、品目ごとの相対的なずれ、あるいは予測の偏りなど、注目する観点によって得られる情報が違います。単一の指標だけに頼ると、予測の弱点を見逃す可能性があります。
したがって、複数の指標を組み合わせることで、予測の全体像と個別の課題を把握できます。これにより、在庫政策の調整やモデルの改善方向を明確にできます。数値で裏付けられた評価が、実務的な意思決定を支える基盤となります。
MAE・MAPE・WAPE・バイアスの定義
予測精度を評価する指標として、平均絶対誤差(MAE)、平均絶対パーセント誤差(MAPE)、加重MAPE(WAPE)、バイアスがあります。これらは計算式と意味が異なります。本節では、それぞれの定義と、数値が示す内容を説明します。なお、後続の節で使用する計算例の数値は、乱数で生成した架空のサンプルデータによるものです。
MAE(平均絶対誤差)は、予測値と実績値の差の絶対値を平均したものです。単位は個数など、実績と同じ単位になります。誤差の大きさをそのまま示すため、品目ごとの誤差の規模を把握するのに適しています。
MAPE(平均絶対パーセント誤差)は、各期の誤差を実績で割った割合の平均です。単位はパーセントになります。実績に対する相対的な誤差率を示しますが、実績が 0 の期は計算できません。また、実績が小さい期の誤差率が極端に大きくなる傾向があります。
WAPE(加重MAPE)は、誤差の合計を実績の合計で割ったものです。単位はパーセントになります。品目横断で全体の精度を見るときに用いられます。金額や数量の重みが付くため、品目ごとの規模差を反映した評価が可能です。
バイアスは、実績から予測を引いた差の平均です。本記事では「実績 − 予測」の定義を用います。正の値であれば過小予測、負の値であれば過大予測を示します。予測の偏りの方向性を確認するために使います。なお、バイアスの符号は定義によって変わるため、社内で定義を統一することが重要です。
(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
Pythonで 4 つの指標を計算する
Python では、NumPy を使って予測精度の指標を計算できます。まず、実績と予測の配列を受け取り、MAE・MAPE・WAPE・バイアスの 4 つを返す関数を用意します。この関数は、各指標の定義に従って数値を算出し、結果をまとめて出力します。
MAE・MAPE・WAPE・バイアスを計算する関数
def mae(actual, forecast):
    """平均絶対誤差。誤差の大きさの平均(単位は実績と同じ)。"""
    return sum(abs(a - f) for a, f in zip(actual, forecast)) / len(actual)


def mape(actual, forecast):
    """平均絶対パーセント誤差。各期の |誤差| ÷ 実績 の平均。実績が 0 の期は除外する。"""
    pairs = [(a, f) for a, f in zip(actual, forecast) if a != 0]
    return 100 * sum(abs(a - f) / abs(a) for a, f in pairs) / len(pairs)


def wape(actual, forecast):
    """加重 MAPE。|誤差| の合計 ÷ 実績の合計。実績が大きい期ほど重みが大きい。"""
    return 100 * sum(abs(a - f) for a, f in zip(actual, forecast)) / sum(abs(a) for a in actual)


def bias(actual, forecast):
    """バイアス(平均誤差)= (実績 − 予測) の平均。正なら予測が低すぎ(過小予測)、負なら高すぎ。"""
    return sum(a - f for a, f in zip(actual, forecast)) / len(actual)
次に、この関数を使って 3 つの SKU について計算例を実行します。計算例の数値は、乱数で生成した架空のサンプルデータによるものです。SKU-A は月 500 個前後の安定した需要に対し、偏りのない予測を行っています。SKU-B は月 800 個前後の需要に対し、常に約 1 割低い予測となっています。SKU-C は多くの月で数個、時々 40〜120 個となる断続的な需要に対し、毎月 30 個の一定予測を行っています。
性質の違う 3 つの品目(安定、常に低め、断続的)で各指標を計算する
import numpy as np

rng = np.random.default_rng(5)                                 # 固定シード(毎回同じ架空データ)
months = 12
skus = {
    # SKU-A: 安定した需要と、ばらつきだけの誤差
    "SKU-A": (500 + rng.normal(0, 30, months), 500 + rng.normal(0, 30, months)),
    # SKU-B: 予測が常に実績より 1 割ほど低い(偏りのある予測)
    "SKU-B": (800 + rng.normal(0, 40, months), 0.9 * (800 + rng.normal(0, 20, months))),
    # SKU-C: 断続的な需要(ほとんど 0 に近く、時々まとまって出る)に対して一定の予測
    "SKU-C": (np.where(rng.random(months) < 0.4, rng.integers(40, 120, months), rng.integers(1, 8, months)), np.full(months, 30)),
}
for name, (actual, forecast) in skus.items():
    a, f = [round(float(x)) for x in actual], [round(float(x)) for x in forecast]
    print(f"{name}: MAE={mae(a, f):.1f}  MAPE={mape(a, f):.1f}%  WAPE={wape(a, f):.1f}%  バイアス={bias(a, f):+.1f}")
実行結果は以下の通りです。SKU-A は MAPE が 6.0%、バイアスが +8.6個 と、比較的小さい誤差と偏りが見られます。SKU-B は MAPE が 9.2%、バイアスが +72.9個 と、予測が常に低めに出ていることが示されています。SKU-C は MAPE が 559.1% と非常に大きくなっていますが、これは実績が小さい期の誤差率が極端に大きくなるためです。一方、WAPE は 101.7% であり、MAPE とは大きく異なる結果になります。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
MAPE と WAPE はなぜ食い違うのか
品目ごとの MAPE と WAPE を比較すると、数値に大きな開きが見られます。
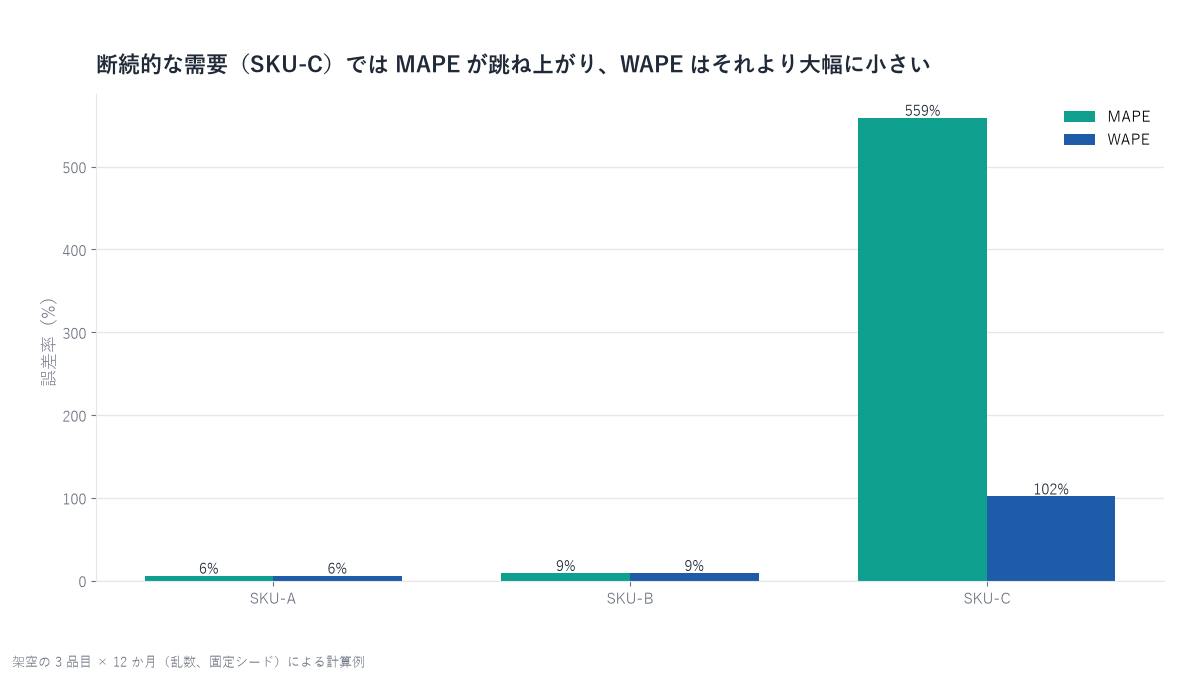
特に SKU-C では、MAPE が 559.1% になる一方、WAPE は 101.7% です(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。この差は、実績が非常に少ない月があることによります。
SKU-C の需要は断続的で、多くの月は数個にとどまります。実績が 2個 しかない月では、予測 30 個との差を実績で割るため、誤差率が 1400% にもなります。MAPE は各月の誤差率を単純に平均するため、こうした極端な値が全体の指標を大きく押し上げます。
一方、WAPE は誤差の合計を実績の合計で割るため、実績が少ない月の影響が相対的に小さくなります。SKU-C の WAPE が 100% を超えているのは、予測誤差の合計が実績の合計を上回ったことを示しています(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
バイアスが示す「偏り」
バイアスは、予測が高めと低めのどちらに偏って振れているかを示す指標です。ここでは「実績 − 予測」で定義します。この値がプラスであれば、予測が実績より低く出ていることを意味します。
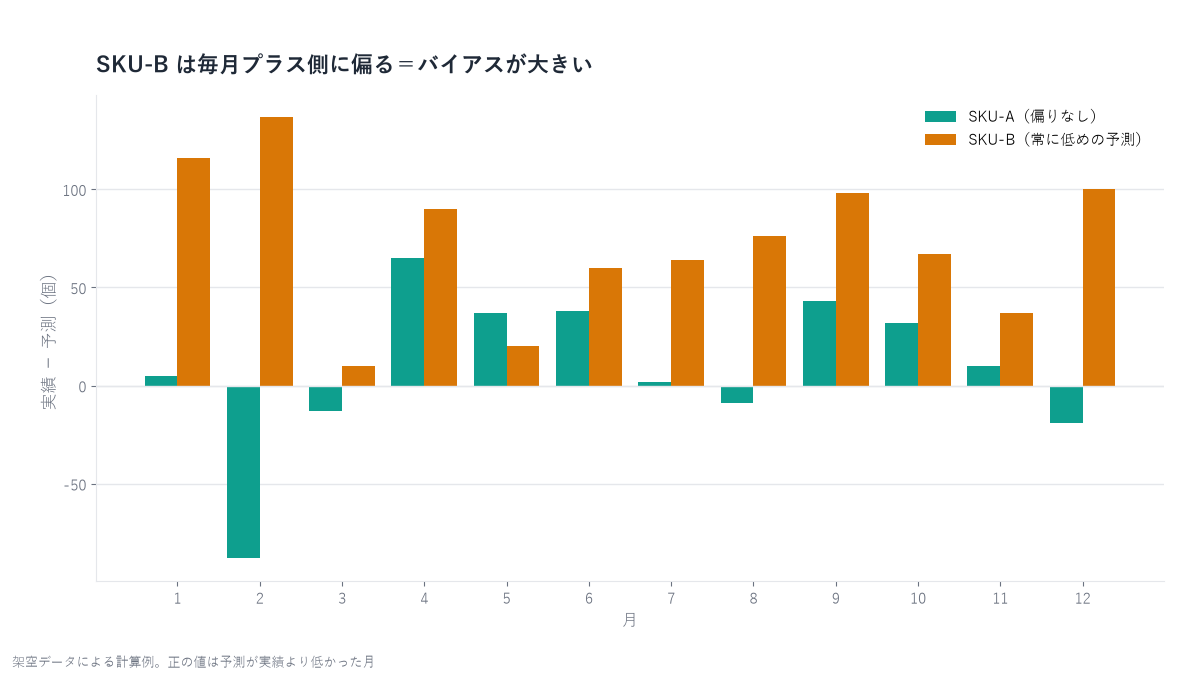
図は、12か月の誤差を品目別に並べたものです。SKU-B は毎月プラス側になっています。これは、需要に対して常に約 1 割低い予測をしていた結果です。一方、SKU-A は安定した需要に対して偏りのない予測を行っていました。
この 2 つの品目の精度を比較してみましょう。SKU-A の MAPE は 6.0%、SKU-B は 9.2% です(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。MAPE だけを見ると、9.2% と 6.0% の差は大きくありません。しかし、バイアスを見ると、SKU-A は +8.6個、SKU-B は +72.9個と、大きな開きがあります(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
MAPE は誤差の大きさを平均したもので、方向性は含みません。そのため、常に低めに出ている SKU-B のような「一貫した偏り」は、MAPE だけでは見えにくくなります。バイアスを見ることで、予測がどの方向にずれているかが明確になり、在庫切れや過剰在庫といった具体的なリスクを把握しやすくなります。
実務での指標の使い分け
実務では、評価の目的に応じて指標を使い分けることが重要です。品目横断で全体の精度を把握したい場合は、金額や数量の重みが付く WAPE が適しています。一方、特定の品目ごとの改善点を探す際は、MAPE とバイアスを併せて見ることで、誤差の大きさだけでなく偏りの方向性も確認できます。
ただし、MAPE は実績が 0 の期を計算できず、実績が小さい期の誤差率が極端に大きくなるため、断続的な需要の品目には向かない点に注意が必要です。また、バイアスの符号は定義によって変わるため、社内での定義統一が不可欠です。
評価を行う際は、予測を作った後の実績(未来のデータ)を用い、評価期間は季節を一巡する 12か月以上を目安とします。これにより、一時的な変動ではなく、安定した傾向に基づいた精度評価が可能になります。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
まとめ
予測精度の評価では、指標の定義と使い分けが重要です。まず、品目ごとの改善点を探る際は MAPE とバイアスを併用し、全体像を把握する際は WAPE を用いるとよいでしょう。また、MAPE は実績が 0 の期を計算できないため、断続的な需要を持つ品目には向いていません。最後に、評価は予測後の実績データに対して行い、期間としては季節を一巡する 12か月以上を目安に設定してください。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
計算方法と注意
- SKU-A は安定した需要(月 500 個前後)に対して偏りのない予測、SKU-B は需要(月 800 個前後)に対して常に約 1 割低い予測、SKU-C は断続的な需要(多くの月は数個、時々 40〜120 個)に対して毎月 30 個の一定予測
- 品目横断で全体の精度を見るときは WAPE(金額や数量の重みが付く)、品目ごとの改善点を探すときは MAPE とバイアスを併せて見る
- MAPE は実績が 0 の期を計算できず、実績が小さい期の誤差率が極端に大きくなる。断続的な需要の品目には向かない
- バイアスの符号は定義で変わる(ここでは 実績 − 予測)。社内で定義を統一する
- 評価は予測を作った後の実績(未来のデータ)で行い、評価期間は季節を一巡する 12 か月以上を目安にする
- 計算例の数値は乱数で生成した架空のサンプルデータによるもの
出典
- 本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード)
関連記事
本記事のコードと数値は、乱数で生成した架空のサンプルデータによる再現可能な計算例です。