Holt-Winters法(三重指数平滑法)を用いた季節性のある需要予測のPython実装を解説します。水準・傾き・季節成分の3要素を分解し、検証期間のMAPEが2.6%となる予測精度を確認します。
季節性のある需要に移動平均が向かない理由
月ごとの需要に明確な山谷があり、さらに緩やかな増加傾向がある場合、単純な移動平均では予測が遅れやすくなります。直近の平均値を基準にするため、季節の波やトレンドの変化に追いつけず、過大または過小の予測になりがちです。
Holt-Winters法(三重指数平滑法)は、この問題を解決するために設計されています。この手法は、需要の構造を「水準」「傾き」「季節成分」の3つに分解し、それぞれを独立して追跡します。これにより、過去の平均だけに依存するのではなく、トレンドや季節の変動を追跡しやすくなります。
特に、季節の振れ幅が水準に比例して大きくなるデータでは、季節成分を掛け算で扱う乗法型が適しています。一方、振れ幅が一定の場合は加法型を使います。Holt-Winters法は、これらの成分を分けて更新することで、季節性のある需要の予測精度を高めることを目指します。
Holt-Winters法の仕組み
Holt-Winters法(三重指数平滑法)は、水準・傾き・季節性の3要素を同時に追跡する手法です。ここでは、季節の振れ幅が一定とみなせる加法型について説明します。計算例に用いる数値は、乱数で生成した架空のサンプルデータによるものです(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
この手法では、3つの状態量を更新します。まず「水準」は、季節の影響を除いた現在の需要の中心値です。次に「傾き」は、需要が時間とともに増減する速度を表します。最後に「季節成分」は、特定の月や四半期に特有の増減の幅を保持します。
これらを更新する際、それぞれ平滑化係数 α(アルファ)、β(ベータ)、γ(ガンマ)を使います。α は水準の追従の速さを、β は傾きの追従の速さを、γ は季節成分の追従の速さを決めます。これらの係数は、学習期間中の誤差が最小になる組み合わせを、候補の中から選んで決めます(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
予測値は、現在の水準に、傾きと予測する先の期数を掛けた値、さらに該当する月の季節成分を加算して求めます。つまり、予測 = 水準 + 傾き × 先の期数 + 季節成分 という式になります。この構造により、トレンドと季節変動の両方を反映した予測が可能になります。
Pythonで実装する
Holt-Winters法の実装は、初期化と更新ループ、そして将来の予測という3つのステップで構成されます。まず、過去のデータから水準・トレンド・季節成分の初期値を決定します。次に、各時点の誤差に基づいて係数 α・β・γ を用いて状態を更新します。最後に、予測したい期間分だけ状態を先へ進めて予測値を出力します。
加法型 Holt-Winters(水準・傾き・季節成分の 3 つの平滑化)と先の期間の予測
def holt_winters_additive(y, period, alpha, beta, gamma):
    """加法型 Holt-Winters。各期で水準・傾き・季節成分を更新し、1 期先の予測も記録する。

    戻り値: (最終の水準, 最終の傾き, 季節成分のリスト, 1 期先予測のリスト)
    """
    level = sum(y[:period]) / period                                  # 初期水準: 最初の 1 周期の平均
    trend = (sum(y[period:2 * period]) - sum(y[:period])) / (period * period)   # 初期傾き: 周期間の平均差 ÷ 周期
    seasonal = [y[i] - level for i in range(period)]                  # 初期季節成分: 最初の周期の平均からのずれ
    fitted = [None] * period
    for t in range(period, len(y)):
        s = seasonal[t % period]
        fitted.append(level + trend + s)                              # 更新前の状態で 1 期先を予測
        new_level = alpha * (y[t] - s) + (1 - alpha) * (level + trend)
        trend = beta * (new_level - level) + (1 - beta) * trend
        seasonal[t % period] = gamma * (y[t] - new_level) + (1 - gamma) * s
        level = new_level
    return level, trend, seasonal, fitted


def hw_forecast(level, trend, seasonal, period, next_index, horizon):
    """最終状態から horizon 期先までを予測する。next_index は最後の観測の次の添字。"""
    return [level + (h + 1) * trend + seasonal[(next_index + h) % period] for h in range(horizon)]
この関数は、月次需要の配列と係数を受け取り、予測値の配列を返します。計算例では、乱数で生成した架空のサンプルデータを使用します。データは全48か月で、最初の36か月を学習期間、最後の12か月を検証期間として分割します。季節の周期は12か月と設定しています(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
架空の月次需要 48 か月で、最初の 36 か月から学習し最後の 12 か月を予測する
import numpy as np

rng = np.random.default_rng(11)                                       # 固定シード(毎回同じ架空データ)
period, n_months = 12, 48
season = [-120, -150, -60, 40, 90, 110, 140, 160, 60, -20, -80, -170]  # 月ごとの季節的な上乗せ・下押し
y = [1000 + 6 * t + season[t % period] + rng.normal(0, 35) for t in range(n_months)]

train, test = y[:36], y[36:]                                          # 最初の 36 か月で学習、最後の 12 か月で検証
best = None
for a in (0.1, 0.2, 0.3, 0.4, 0.5):                                   # 係数は学習期間の誤差が最小になる組を選ぶ
    for b in (0.01, 0.05, 0.1):
        for g in (0.1, 0.2, 0.3, 0.4):
            _, _, _, fitted = holt_winters_additive(train, period, a, b, g)
            err = sum(abs(v - f) for v, f in zip(train[period:], fitted[period:])) / (len(train) - period)
            if best is None or err < best[0]:
                best = (err, a, b, g)
_, alpha, beta, gamma = best
level, trend, seasonal, fitted = holt_winters_additive(train, period, alpha, beta, gamma)
forecast = hw_forecast(level, trend, seasonal, period, len(train), len(test))
mae = sum(abs(v - f) for v, f in zip(test, forecast)) / len(test)
print(f"α={alpha} β={beta} γ={gamma}  12か月先の MAE={mae:.1f}")
実行例では、格子状の候補から誤差が最小になる係数の組を選びます。ここでは、α=0.1、β=0.01、γ=0.4 が選択されました。これらの係数は、学習期間中の予測誤差を最小化する役割を果たします(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
予測と実績を比べる
まず、予測の全体像を確認します。
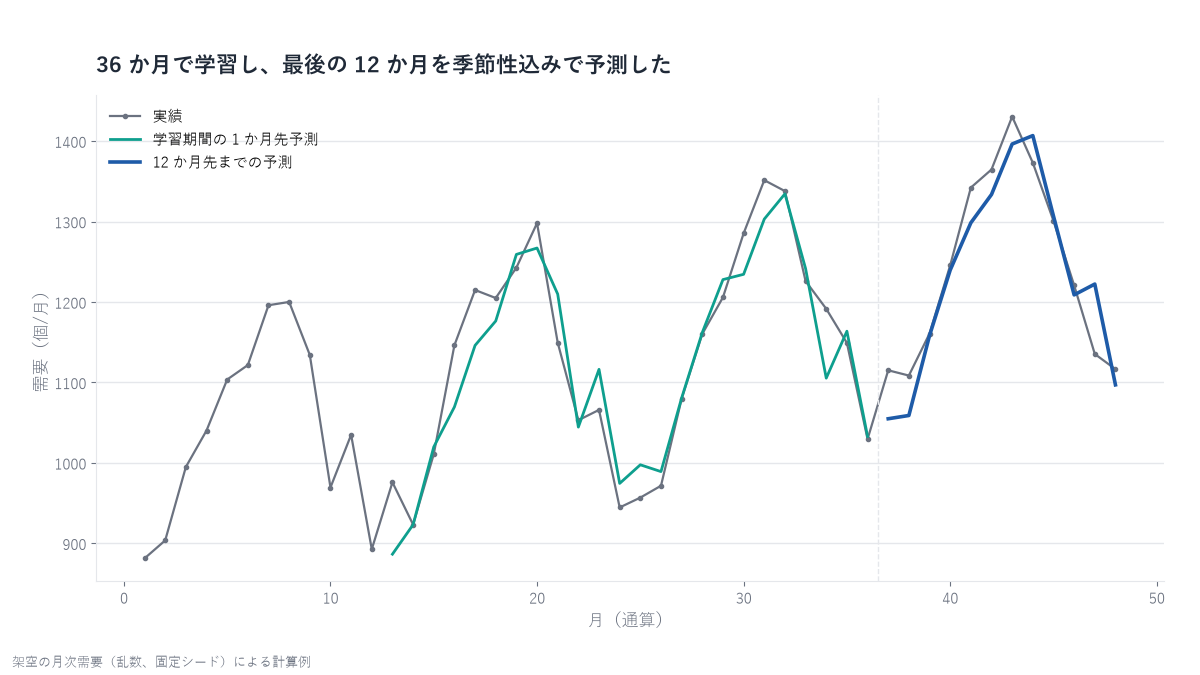
このグラフは、48か月の月次需要の実績と、Holt-Winters法による予測を重ねたものです。最初の36か月で学習し、最後の12か月を予測しています。実績の波と予測の波が概ね追従していることが読み取れます。
次に、検証期間(最後の12か月)の月別の詳細を見ます。
| 月 | 実績 | 予測 | 誤差率 |
|---|---|---|---|
| 37か月目(1月) | 1115個 | 1055個 | -5.4% |
| 38か月目(2月) | 1109個 | 1059個 | -4.5% |
| 39か月目(3月) | 1161個 | 1158個 | -0.2% |
| 40か月目(4月) | 1246個 | 1240個 | -0.5% |
| 41か月目(5月) | 1342個 | 1298個 | -3.3% |
| 42か月目(6月) | 1365個 | 1334個 | -2.3% |
| 43か月目(7月) | 1430個 | 1396個 | -2.4% |
| 44か月目(8月) | 1373個 | 1407個 | +2.5% |
| 45か月目(9月) | 1301個 | 1307個 | +0.5% |
| 46か月目(10月) | 1221個 | 1209個 | -1.0% |
| 47か月目(11月) | 1135個 | 1222個 | +7.7% |
| 48か月目(12月) | 1116個 | 1097個 | -1.7% |
(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
これらの数値は、乱数で生成した架空のサンプルデータによるものです。検証期間の平均絶対誤差(MAE)は32.1個、平均絶対パーセント誤差(MAPE)は2.6%でした。
一方、比較のために用いた単純な予測方法のMAPEは6.8%です。Holt-Winters法の2.6%と比べると誤差が小さくなっており、少なくともこのサンプルデータでは、水準・傾き・季節成分を分けて追跡することで予測精度が高まったと読めます。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
季節成分を読む
Holt-Winters法では、需要の水準やトレンドとは別に、月ごとの季節的な振れを「季節成分」として推定します。この成分は、全体の平均からの上乗せまたは下押しとして解釈できます。
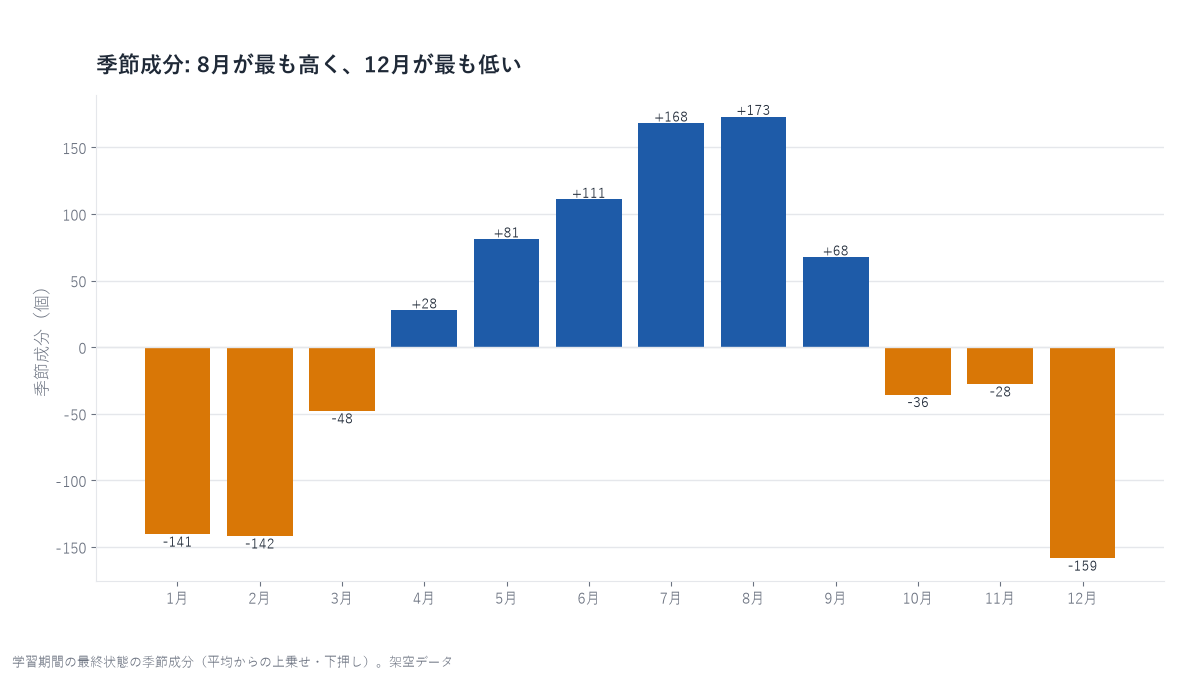
推定された季節成分を見ると、8月が最も高く、平均に対して+173個の上乗せとなっています。一方、12月は最も低く、平均に対して-159個の下押しを示しています(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
このように、季節成分は「どの月が繁忙期で、どの月が閑散期か」を数値で示します。実務では、この棒グラフの形状を参考に、在庫計画や人員配置のタイミングを調整する手がかりとできます。
実務で使うときの注意点
Holt-Winters法を実務で使う際は、いくつかの前提条件を確認してください。まず、季節の周期が明確であることが必要です。ここでは12か月を1周期として扱います。データ量は、少なくとも2周期分、つまり24か月分あることが望ましいです。3周期分、36か月分あると、係数の推定が安定しやすくなります。
係数α・β・γは、学習期間の誤差が最小になる組を探して決めます。今回は格子状の候補から選定しました。また、季節の振れ幅が水準に比例して大きくなるデータでは、加法型ではなく乗法型(季節成分を掛ける)を使うのが適切です。
需要の構造が変わった直後は注意が必要です。新製品の投入や販路の変更など、過去の季節パターンが当てはまらなくなる場面では、モデルの追随が遅れる可能性があります。これらの点を踏まえて、データの性質に合った型を選択し、十分な期間のデータを用いることが重要です。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
まとめ
Holt-Winters法は、水準・トレンド・季節性の3要素を同時に捉えることで、移動平均では表現しきれない季節変動に対応できます。Pythonで実装し、架空のサンプルデータでは検証期間のMAPEが2.6%と誤差が小さいことを確認できました。実務では、季節の振れ幅の性質に応じた加法型と乗法型の使い分けや、十分な期間のデータの確保が重要です。
(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
計算方法と注意
- 前提: 季節の周期(ここでは 12 か月)が分かっていて、少なくとも 2 周期分(24 か月)のデータがある。3 周期分(36 か月)あると係数の推定が安定しやすい
- 係数 α・β・γ は学習期間の誤差が最小になる組を探して決める(ここでは格子状の候補から選んだ)
- 季節の振れ幅が水準に比例して大きくなるデータでは、加法型ではなく乗法型(季節成分を掛ける)を使う
- 需要の構造が変わった直後(新製品、販路の変更など)は、過去の季節パターンが当てはまらず追随が遅れる
- 計算例の数値は乱数で生成した架空のサンプルデータによるもの
出典
- 本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード)
関連記事
本記事のコードと数値は、乱数で生成した架空のサンプルデータによる再現可能な計算例です。