需要予測の基礎である移動平均と指数平滑法を、Pythonで実装して比較します。乱数で生成した架空データを用い、平滑化係数αの影響や予測誤差(MAE・MAPE)の傾向を解説します。
需要予測の出発点は「直近の実績をどう均すか」
需要予測の最も基本的な考え方は、過去の実績を「均す」ことで、次の期間の需要を見込むことです。日々の需要は乱高下するため、直近の値をそのまま使うと予測が不安定になります。そこで、複数の実績を重み付けして一つの値にまとめる手法が用いられます。
この「均す」作業の代表が、移動平均と指数平滑法です。どちらも過去のデータから未来の値を推定しますが、古い実績をどう扱うかが異なります。移動平均は直近の一定期間だけを見ます。一方、指数平滑法は全期間のデータを使い、古い実績ほど重みを小さくして計算します。
どちらの手法も、需要に明確なトレンドや季節性が無い場合に適しています。トレンドや季節性があるデータには、Holt-Winters 法など別の手法を使うのが一般的です。まずはこの基本的な枠組みを理解し、自分のデータに合う方法を選ぶことが重要です。
移動平均と指数平滑法の計算式
需要予測では、直近の実績をどのように均すかが出発点です。ここでは、移動平均と単純指数平滑法の計算式を説明します。なお、後述する数値例は乱数で生成した架空のサンプルデータによるものです。
移動平均は、直近の window 期の実績の平均を予測値とします。window が大きいほど、過去のデータの影響が長期間残ります。一方、単純指数平滑法は、直近の実績と前回の予測値を重み付けして次の予測を作ります。式は「予測 = α × 直近実績 + (1 − α) × 前回予測」となります。
この式における平滑化係数 α は、直近の実績をどれだけ重視するかを決めます。α が大きいほど直近の実績の影響が大きく、小さいほど過去の予測の影響が強く残ります。本記事では、α を 0.3、window を 7日 と設定して比較します(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
両手法とも、需要に明確なトレンドや季節性が無い場合に適した手法です。トレンドや季節性があるデータには、Holt-Winters 法などを使う必要があります。
Pythonで 2 つの予測を実装する
ここでは、移動平均と指数平滑法の予測ロジックを Python で実装します。まず、予測値を計算する関数を用意します。この関数は、過去の実績データと手法の条件を受け取り、将来の予測値のリストを返します。
移動平均と単純指数平滑法の 1 期先予測を返す関数
def moving_average_forecast(series, window):
    """直近 window 期の平均を次の期の予測にする(最初の window 期は予測なし)。"""
    forecasts = [None] * window
    for t in range(window, len(series)):
        forecasts.append(sum(series[t - window:t]) / window)
    return forecasts


def ses_forecast(series, alpha):
    """単純指数平滑法。次の予測 = α × 直近の実績 + (1 − α) × 前回の予測。初期値は最初の実績。"""
    forecasts = [None, series[0]]
    for t in range(1, len(series) - 1):
        forecasts.append(alpha * series[t] + (1 - alpha) * forecasts[t])
    return forecasts
次に、この関数を実際に動かすための実行例を示します。ここでは、乱数で生成した架空のサンプルデータを使用します。データは 180日 分あり、平均的な需要は 74個、ばらつき(標準偏差)は 17個 です。予測の精度評価は、学習に使っていない最後の 60日 を対象に行います。
架空の日次需要 180 日分で、最後の 60 日の予測誤差を比べる
import numpy as np

rng = np.random.default_rng(7)                               # 固定シード(毎回同じ架空データ)
days = 180
level = 100 + np.cumsum(rng.normal(0, 1.5, days))            # ゆっくり動く需要水準
demand = np.maximum(0, level + rng.normal(0, 12, days)).round()

window, alpha = 7, 0.3
f_ma = moving_average_forecast(list(demand), window)
f_ses = ses_forecast(list(demand), alpha)

test = range(days - 60, days)                                 # 最後の 60 日で精度を比べる
mae = lambda f: sum(abs(demand[t] - f[t]) for t in test) / len(test)
print(f"MAE  移動平均={mae(f_ma):.1f}  指数平滑={mae(f_ses):.1f}")
実行結果として、両手法の平均絶対誤差(MAE)が算出されました。移動平均(7日)の MAE は 9.3個、指数平滑(α=0.3)の MAE は 9.6個 でした。この架空データでは、移動平均のほうがわずかに誤差が小さい結果となっています。ただし、どちらの手法が優れているかはデータの内容次第であり、この結果から手法の優劣を一般化することはできません。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
予測の動きを実績と重ねて見る
ここでは、最後の 60 日間の実績と、2 つの手法による 1 日先の予測を比較します。計算例の数値は、乱数で生成した架空のサンプルデータによるものです(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
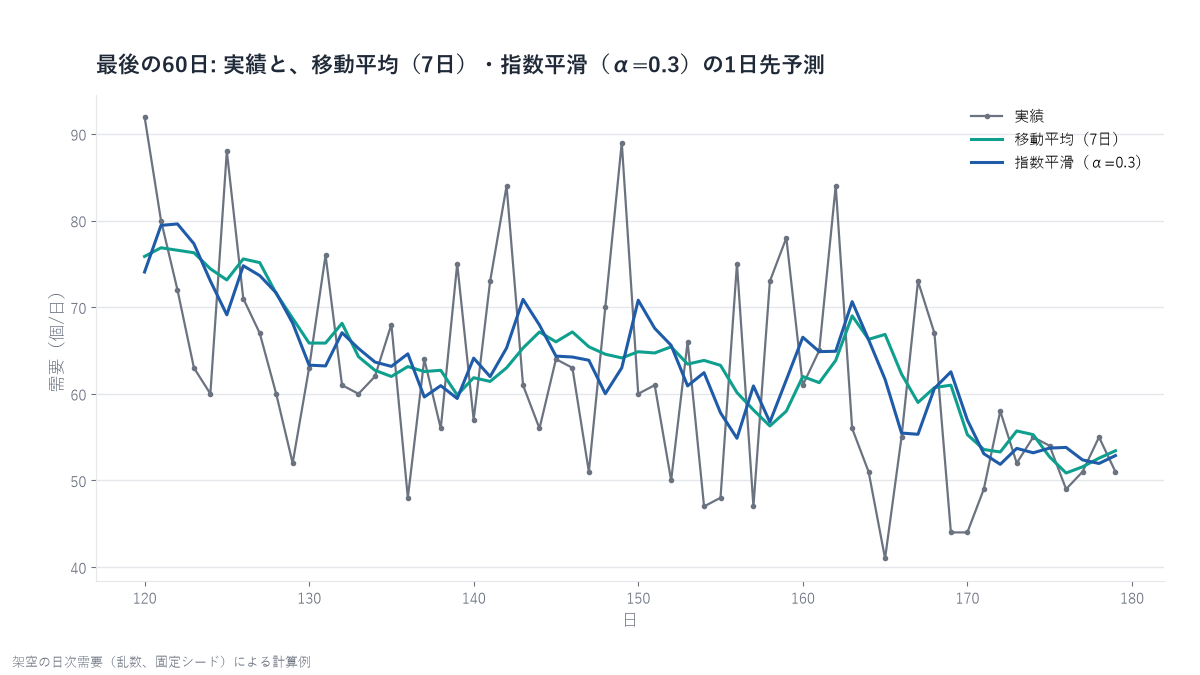
図を見ると、移動平均と指数平滑法の予測は、実績の動きに少し遅れて追随しています。これは、両手法とも過去の実績を平滑化して予測するため、急激な変化には反応が遅れる特性を示しています。
予測の精度は、学習に使っていない期間で評価します。下表は、最後の 60 日間の予測誤差を示しています(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
| 手法 | MAE | MAPE |
|---|---|---|
| 移動平均(7日) | 9.3個 | 15.4% |
| 指数平滑(α=0.3) | 9.6個 | 15.8% |
この架空データでは、移動平均の MAE が 9.3個、MAPE が 15.4% でした。一方、指数平滑法は MAE が 9.6個、MAPE が 15.8% でした。移動平均に対する指数平滑の MAE の差は +3.5% であり、正の値であることから、このデータでは指数平滑法のほうが誤差が大きいと読めます(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
ただし、どちらの手法が良いかはデータ次第です。この結果から手法の優劣を一般化することはできません。実際のデータでは、需要の特性によって結果が変わるため、個別に評価が必要です。
平滑化係数 α の選び方
平滑化係数 α は、直近の実績をどれほど強く反映させるかを制御するパラメータです。α が大きいほど新しいデータに重みを置き、小さいほど過去の平均に近づきます。この係数は理論上の最適値が決まっているわけではなく、対象となる需要データに合わせて調整する必要があります。
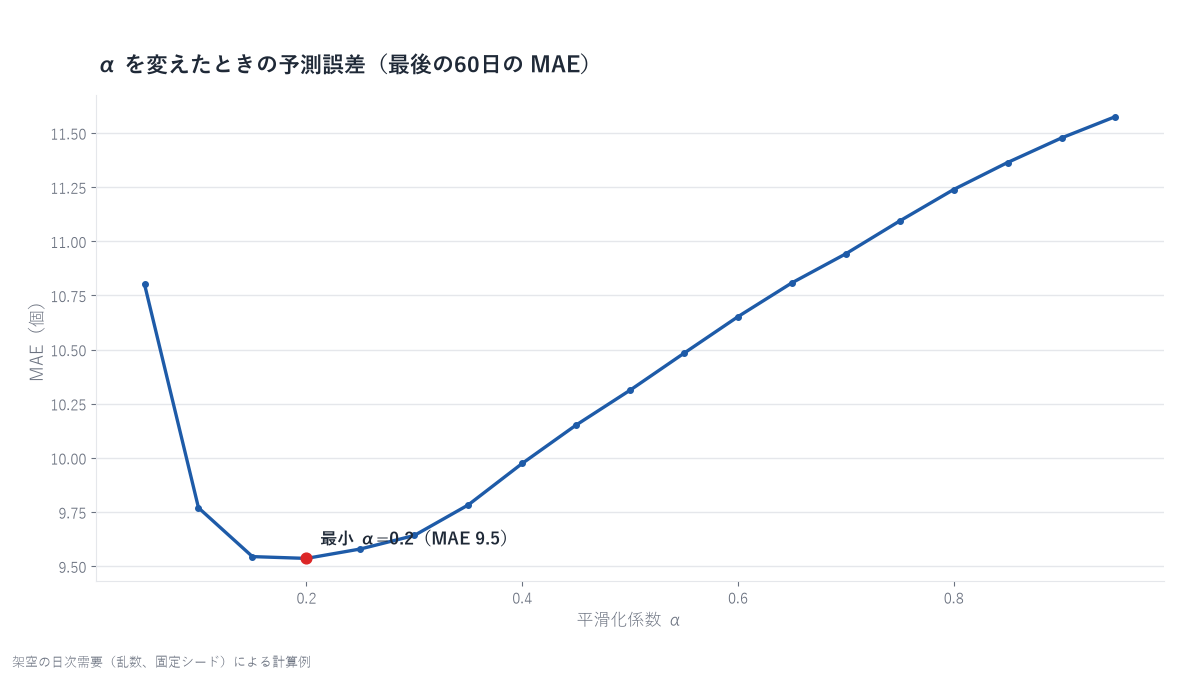
上の図は、α を 0.05 から 0.95 まで変化させたときの予測誤差(MAE)を示しています。α が 0.1 のときは MAE が 9.8個、0.9 のときは 11.5個となりました。一方、α が 0.2 のときに MAE は 9.5個となり、この範囲内で最小の誤差を示しています(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))。
この結果から、α は一律に決めるのではなく、検証期間の誤差を最小化する値をデータから選ぶことが重要だとわかります。
実務で使うときの注意点
移動平均と指数平滑法は、需要に明確なトレンドや季節性が無い場合に適した手法です。トレンドや季節性があるデータには、Holt-Winters 法などを使う必要があります。
外れ値への対応も異なります。大口受注などの外れ値は、移動平均では window 期の間だけ影響します。一方、指数平滑法では減衰しながら予測に残り続けます。
予測の精度評価は、学習に使っていない期間で行います。ここでは最後の 60 日を使って評価しました。この架空データでは、移動平均(7日)の MAE が 9.3個、指数平滑(α=0.3)の MAE が 9.6個でした。指数平滑の誤差は移動平均に対して +3.5% 大きいです。ただし、どちらが良いかはデータ次第であり、手法の優劣は一般化できません。(出典:本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード))
まとめ
移動平均と指数平滑法は、直近の実績の重み付け方が異なります。移動平均は直近の期間のみを等しく使い、指数平滑法は古い実績ほど重みを減らします。予測精度は学習に使っていない期間で評価し、手法の優劣はデータ次第です。平滑化係数 α は、誤差が最小になる値を選ぶのが基本です。
計算方法と注意
- 前提: 需要に明確なトレンドや季節性が無い場合の手法。トレンドや季節性があるデータには Holt-Winters 法などを使う
- 移動平均は window 期より前の実績を一切使わず、指数平滑法は古い実績ほど小さな重みで全期間を使う
- 外れ値(大口受注など)は移動平均では window 期の間、指数平滑法では減衰しながら予測に残る
- 予測の精度は、学習に使っていない期間(ここでは最後の 60 日)で評価する
- ses_vs_ma_pct は「移動平均に対する指数平滑の MAE の差」で、正なら指数平滑のほうが誤差が大きい。この架空データでは移動平均のほうがわずかに良かったが、どちらが良いかはデータ次第で、手法の優劣は一般化できない
- 計算例の数値は乱数で生成した架空のサンプルデータによるもの
出典
- 本記事の Python コードによる計算(乱数で生成した架空のサンプルデータ、固定シード)
関連記事
本記事のコードと数値は、乱数で生成した架空のサンプルデータによる再現可能な計算例です。